
「インデックス数が増えていれば順調で、減っていれば何かまずい」。サーチコンソールの「ページ」レポートを開くと、登録済みのページ数がグラフで真っ先に目に入るため、増減で良し悪しを読みたくなります。しかし、インデックス数は増やす数字ではなく、預けるページを選んだ結果です。一覧ページや同じ内容の別URLまで登録させても、読んでほしい記事が見つかりやすくなるわけではありません。
本記事では、インデックス数の意味と調べ方から、記事数と件数が合わないときの読み分け、数千〜数万ページのサイトで検索させるURLを絞る仕組み、登録を促す手順まで、記事とサイトの両方を手がける立場で順を追ってお伝えします。
- インデックス数はGoogleに登録されたページの本数で、多いほど順位が上がる数字ではない
- 正確な件数と未登録の理由は、サーチコンソールの「ページ」レポートで分かる
- 記事数との差が一覧ページや重複URLなら放置してよく、記事本体が外れていれば直す
- 数千〜数万ページのサイトは、URLの種類ごとに検索させるかを決めてから絞る
- 登録を促す手順は、サイトマップ、内部リンク、URL検査のリクエストの順に進める
SEOにおけるインデックスとは
インデックスとは、検索エンジンがWebページの中身を読み取り、自社のデータベースに登録した状態を指します。日本語にすれば索引で、本の巻末にあるあの索引と役割はほとんど変わりません。索引に載っていない項目は、どれだけ本文に書かれていても引けません。検索エンジンでも事情は同じです。
インデックス数は、検索エンジンのデータベースに登録されているページの本数を指します。サイト側が公開しているページ数と、Googleが登録しているページ数は一致しません。
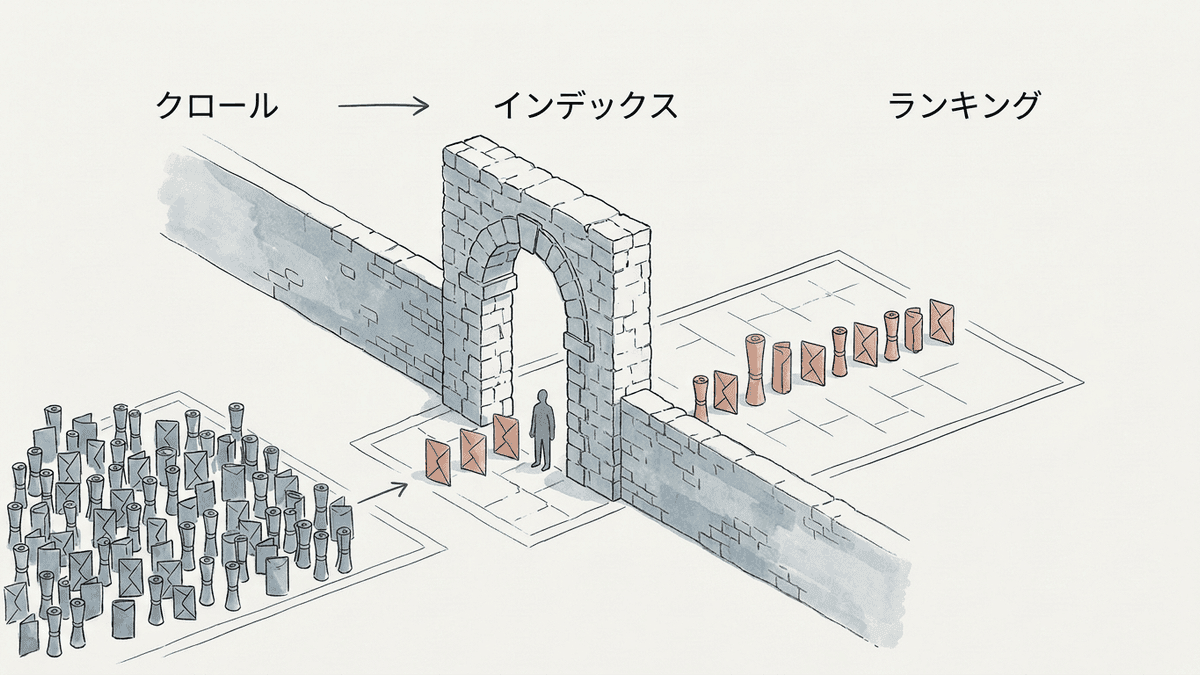
クロールとインデックスとランキングの違い
検索結果にページが並ぶまでには、性質の異なる3つの工程があります。
- クロール:クローラーと呼ばれるプログラムがURLを見つけ、ページの中身を取得する
- インデックス:取得した内容を解析し、データベースに登録するかどうかを判断する
- ランキング:検索された語ごとに、登録済みのページから順番を決める
見落とされやすいのは、1と2のあいだに判断が挟まっている点でしょう。クロールされたページがすべて登録されるわけではありません。読み取ったうえで登録しないという結論もあり得ます。つまりインデックスは登録するかどうかの判断で、順位の判断ではないわけです。クローラーの動き方そのものはGoogleのクローラーの種類と動きでも扱いました。
登録されていないページに順位はつかない
当たり前に見えて、実務では取り違えが起きやすいところです。検索結果は、登録済みのページを並べ替えて表示しているにすぎません。登録されていないページは50位でも100位でもなく、そもそも候補に入っていない状態にあります。
「順位が低い」と「検索結果に出ていない」は、症状が似ていても原因も対処もまったく別です。順位が低いなら中身と競合の話、出ていないならまず登録の話。ここを分けずにリライトを重ねると、直すべき場所に手が届きません。
インデックスがSEOに効く仕組み
インデックスは、サイト単位ではなくページ単位で行われます。トップページが登録されているからといって、配下の記事が自動的に登録されるわけではありません。裏を返せば、どのページも単独で検索の入口になれるということです。
オウンドメディアやブログがSEOで効果を上げる理屈は、まさにここにあります。会社案内のパンフレットであれば表紙から読まれますが、Webでは読者が検索した語に最も近い1ページだけが呼び出されます。トップページを経由せず、3年前に書いた記事に直接お客様が着地します。そうした入口を何十、何百と持てることが、記事を積み上げる本当の価値です。
 Web担当者
インデックスさえされれば、あとは順位も自然に上がっていくものでしょうか。
 Writers-hub
編集部
そこは切り離して考えてください。インデックスは検索の土俵に上がった状態で、順位はその土俵で他社と比べられた結果です。登録された直後に検索結果の後ろのほうに一度出て、そこから数週間かけて位置が動いていくのはよくある動きですが、動いた先が上とは限りません。登録は出発点であって、結果ではないと捉えるのが実務的です。
土俵に上がっていないページを相手に順位対策を考えても、当然ながら何も動きません。だからこそ、施策を打つ前に登録状況を確かめる手順が要ります。
自社サイトのインデックス状況を確認する方法
確認の手段は大きく2つあり、分かることが違います。ざっと見るならブラウザで完結する方法があり、正確に見るならサーチコンソールを使います。
site:検索でおおまかに調べる
Google検索の窓に `site:example.com` と入力すると、そのドメインで登録されているページが一覧で表示されます。`site:example.com/blog/` のようにディレクトリまで書けば範囲を絞れますし、個別記事のURLをそのまま指定すれば、そのページが登録されているかどうかだけを確かめられます。
所有権の確認が不要なので、競合サイトの登録状況を見るときにも使えるのが利点です。
site:検索に出る件数は、あくまで概算です。同じ日でも環境によって数字が動き、数十件単位のずれは珍しくありません。月次のレポートに載せる指標として扱うと、増減の解釈を誤ります。件数は目安、正確な数はサーチコンソールで、と使い分けてください。
サーチコンソールで内訳まで調べる
正確に把握するなら、Google Search Consoleのインデックス作成にある「ページ」レポートを開きます。登録済みと未登録の件数に加えて、未登録のページが「なぜ登録されていないか」まで理由別に並ぶのが、site:検索との決定的な違いです。
個別のページを調べるなら、上部のURL検査に該当のURLを貼り付けます。登録済みかどうか、最後にクロールされた日はいつか、どのURLが正規のものとして扱われているかまで一度に確認できます。
比べる点 | site:検索 | サーチコンソール |
|---|---|---|
分かること | おおよその登録有無 | ページ単位の登録状況と未登録の理由 |
件数の正確さ | 概算で日によって揺れる | 実数に近い件数を確認できる |
必要な権限 | なし | サイトの所有権確認が必要 |
向いている場面 | 競合サイトのざっと確認 | 自社サイトの日常点検 |
日常の運用では、サーチコンソールを中心に据え、site:検索は他社を見るときの道具と位置づけるのが現実的でしょう。
記事数とインデックス数が合わない理由
ここからが、多くの担当者が引っかかるところです。公開した記事は100本なのに登録済みは70件、あるいは逆に250件と表示されます。どちらのずれも起こりますが、原因はまったく違います。
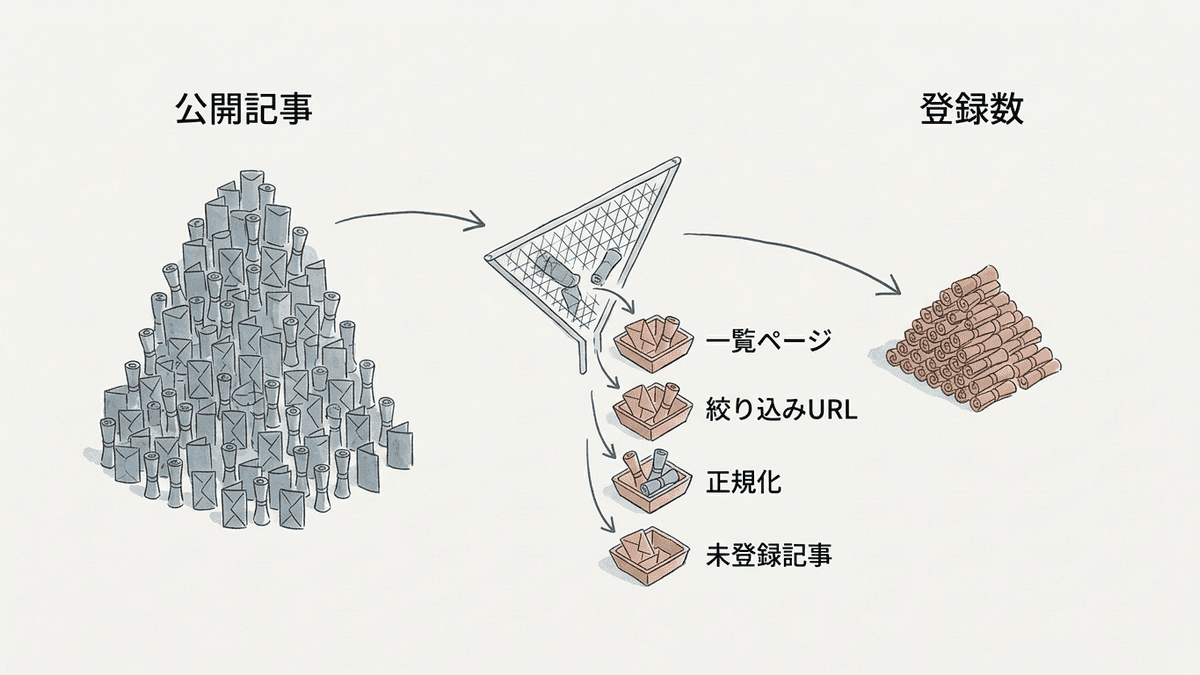
差の中身は、放っておいてよいものと、直すべきものに分かれます。差の中身を分けないまま数だけ追っても打ち手は決まりません。
差があっても問題にならないケース
次のような差であれば、意図どおりに動いている証拠です。
- ページ送りの2ページ目以降が登録されていない
- タグ一覧やカテゴリ一覧といったまとめページが登録されていない
- 並び替えや絞り込みのパラメータが付いたURLが登録されていない
- 同じ内容の別URLが正規化され、代表のURLだけが登録されている
むしろ、これらがすべて登録されているサイトのほうが不健全です。一覧ページや絞り込み結果は、検索した人が着地しても求めている答えが載っていません。どのURLを代表として扱うかの指定についてはcanonicalタグの書き方と使いどころにまとめています。
差を放置してはいけないケース
一方、次の3つが当てはまるなら手を入れる対象です。
- 公開したはずの記事本体が登録されていない
- 更新も削除もしていない記事が、先月まで登録されていたのに外れた
- 登録済みの件数が、公開している記事数を大きく上回っている
3つ目を見落とす方が多いところです。件数が多いぶんには良いと思われがちですが、公開記事の倍以上が登録されている場合、テスト用に作ったURL、印刷用ページ、サイト内検索の結果ページといった、人に見せる前提のないものが混ざっています。
なお、記事を増やすとクロールが追いつかなくなる、という説明を目にすることもあるでしょう。クロールの配分を管理する必要があるのは、主に重複のないページが1万以上あり毎日更新されるような規模の大きいサイトと、URLの大部分が「検出 - インデックス未登録」(Googleが見つけたものの、まだ巡回していない状態)のままのサイトです。数百から数千ページのサイトで、未登録の理由が「検出 - インデックス未登録」に偏っていないのに登録が遅いなら、原因は量ではなく中身の評価にあると見るほうが実態に近いはずです。
内訳を分けたところで、次に必要になるのは「どのページを直し、どのページは触らないか」の判断です。ここは数字だけでは決まりません。
インデックス数を増やす前に決めること
増やし方を調べる前に、決めておくことがあります。インデックス数は多いほど良い、という前提が成り立つのは、登録されるページがどれも検索した人の役に立つ場合だけだからです。
実際のサイトには、検索から人が来る前提のないURLが必ず混ざります。応募フォームの確認画面、社内向けの資料置き場、過去のキャンペーンページ。これらを含めて件数を増やしても、評価してほしい記事が見つかりやすくなるわけではありません。
検索に預けるページと預けないページの線引き
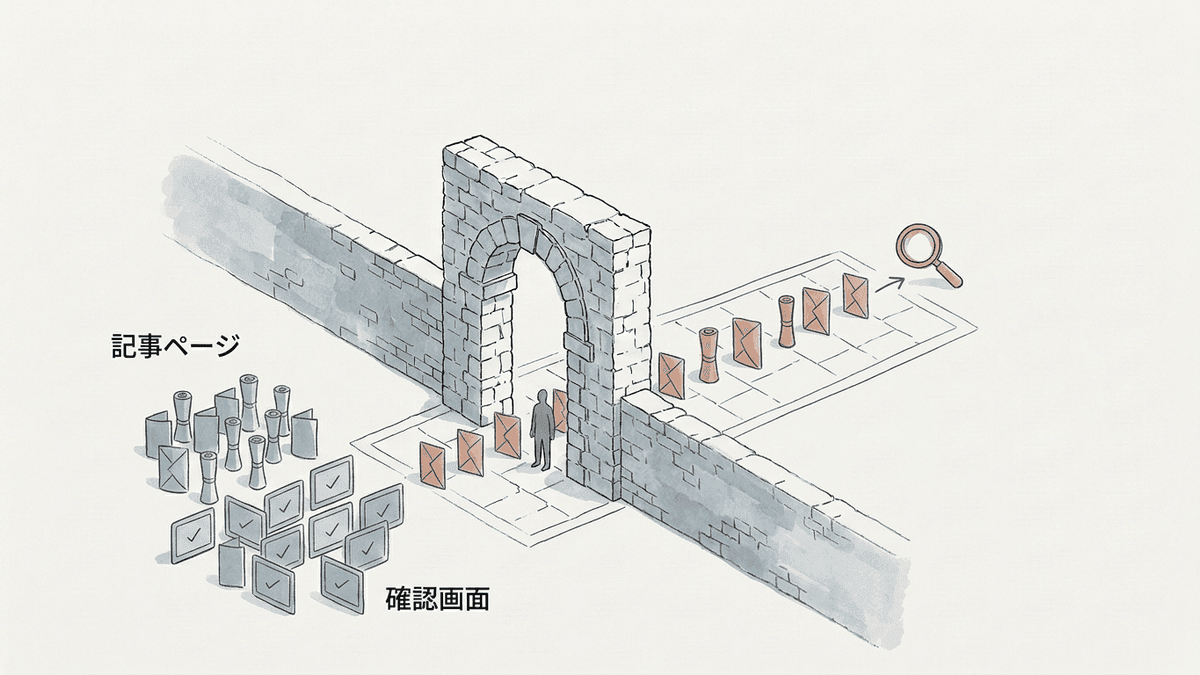
判断の軸は3つで足ります。
- そのページ単体で、検索した人の疑問が片付くか
- そのページにたどり着きたくて検索する人が実際にいるか
- 同じ疑問に答える別のページが、自社サイト内に既にないか
1つでも当てはまらないなら、無理に登録させる必要はありません。とりわけ3つ目は軽視されがちですが、似た内容のページが並ぶと、検索エンジンはどちらを出すべきか判断に迷います。結果としてどちらも中途半端な位置に置かれます。似た記事を2本抱えているなら、統合して1本にするほうが多くの場合は近道です。
noindexは罰ではなく設計
noindexは、質の低いページに貼る烙印のようなものだと受け取られがちです。実際は違います。検索から人を呼ぶ役割を持たせないと決めたページに付ける、設計上の指定にすぎません。
実務上の落とし穴の1つは、robots.txtでクロールをブロックしたページにnoindexを書いても、指定が効かないことです。クローラーがページを読みに行けない以上、そこに書かれたnoindexにも気づけないからです。両方を設定して安心していたのに登録され続けている、という事故はここから起きます。登録を避けたいなら、クロールは許可したうえでnoindexを読ませます。順番が逆になっていないかを確かめてください。
預けるページを絞ると、サイト全体で見たときの平均的な中身の濃さが上がります。預けるページを絞るほど、読んでほしい記事が見つかりやすくなるという関係は、件数を追っているうちは見えてきません。
検索流入のあるページ数という3段目
検索流入のあるページ数は、インデックス数を増やすか絞るかを決めるときに、総ページ数とインデックス数に並べて数える3段目の数字です。実務では、次の3つを別々に数えます。
- 総ページ数:サイトが公開しているページの本数
- インデックス数:Googleの検索データベースに登録されたページの本数
- 検索流入のあるページ数:直近3か月で検索から1回以上訪問があったページの本数
1段目から2段目に減るのは登録されないページがあるためで、2段目から3段目に減るのは順位が付かないページがあるためです。3段目は、サーチコンソールの検索パフォーマンスのレポートで期間を3か月にし、「ページ」タブでクリック数が1以上のページを数えれば出せます。表に出るのは1,000行までなので、検索流入のあるページが1,000を超えるサイトは、Search Console APIでページごとのクリック数を取得して数えます。
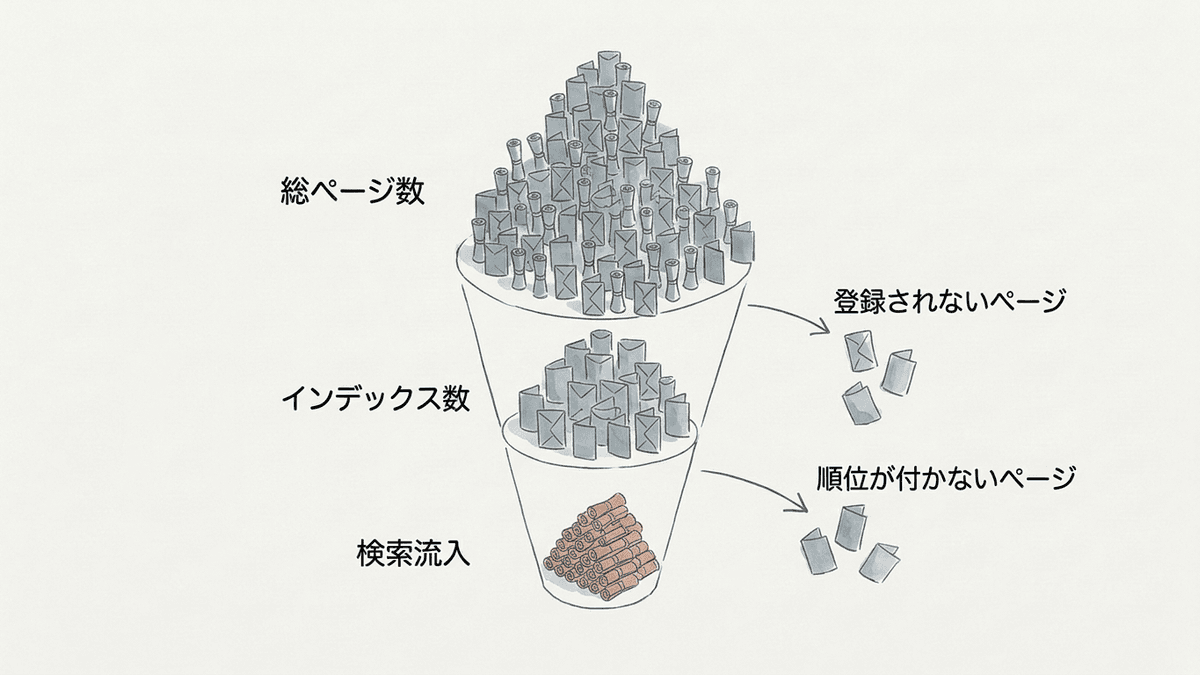
総ページ数に対する3段目の比率を出しておくと、「次に足すべきは新しいページか、既存ページの手直しか」の判断が具体的になります。3段目が極端に低いなら、新規追加より既存ページの見直しが先です。
大規模サイトでインデックスを絞る仕組み
数千〜数万ページのデータベース型サイトでは、インデックス数を増やす前に、検索させるURLの種類を決め、それ以外のURLにクローラーの巡回を使わせない設計が要ります。データベース型サイトとは、求人、不動産、店舗検索のように、データベースの項目を組み合わせてページを自動で作るサイトです。記事を1本ずつ書くサイトと違い、テンプレートを1つ直すと、同じ種類のページがまとめて変わります。テンプレートでページを作るかどうかの判断はプログラマティックSEOの判断基準と設計の手順で扱っています。
条件の組み合わせで増えるURL
データベース型サイトのURLが掲載の件数よりはるかに多くなるのは、並び替えや絞り込みの条件を変えるたびに、別のURLができるためです。URLのパラメータで絞り込みを作る一般的な作り方では、条件の組み合わせの数だけURLが生まれ、次の2つの問題が起きます。
- 過剰なクロール:役に立たない絞り込みのURLかどうかを、クローラーは巡回してみるまで判断できない
- 新しいURLの発見の遅れ:無用なURLの巡回に時間を使うぶん、新しく役に立つURLに回る時間が減る
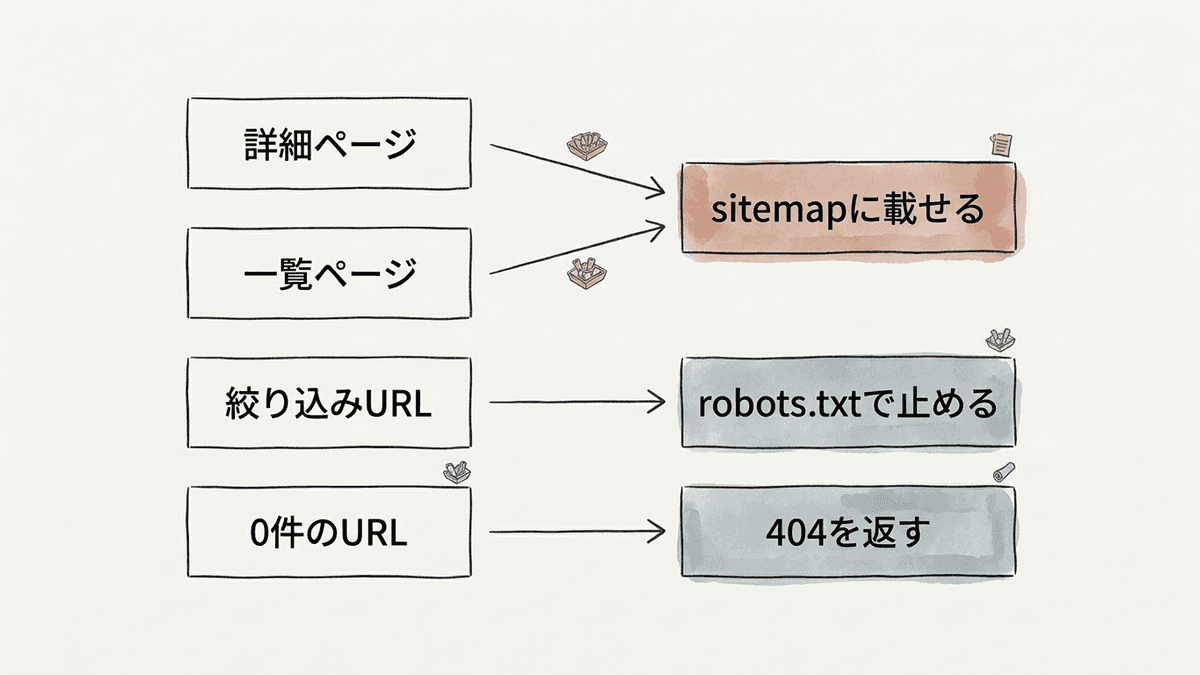
検索させない絞り込みのURLは、robots.txtで巡回を止めます。巡回させるのは、絞り込みをかけていない一覧ページ、掲載ごとの詳細ページ、検索させると決めた条件の一覧ページです。
クロールバジェットが問題になるサイト
クロールバジェットとは、Googleが1つのサイトの巡回に使う時間と資源の割り当てです。サーバーに負担をかけずに巡回できる上限と、Google側がそのサイトを巡回したい度合いの2つで決まります。指示がなければ、Googleは認識しているURLのすべてか、ほとんどを巡回しようとします。重複したURLや重要でないURLが多いと、巡回の時間がそちらに使われます。
クロールバジェットの管理が主に必要になるのは、次の3つのどれかに当てはまるサイトです。
- 重複のないページが100万以上あり、内容が週1回ほど更新される
- 重複のないページが1万以上あり、内容が毎日更新される
- サーチコンソールで、URLの大部分が「検出 - インデックス未登録」に分類される
数値は大まかな目安で、正確なしきい値ではありません。数千〜数万ページのサイトでまず確かめるのは3つ目です。「検出 - インデックス未登録」の多くは、Googleが見つけたものの、サイトへの負荷を見込んで巡回を先送りしたURLを指します。
URLの種類ごとに決める扱い
データベース型サイトで絞るページは、URLを1件ずつではなく、ページの種類ごとに決めます。判断の軸は、単体で疑問が片付くか、検索する人がいるか、同じ疑問に答える別のページがないかの3つです。種類ごとに当てはめると、扱いは次の4つに分かれます。
URLの種類 | 例 | 扱い |
|---|---|---|
掲載ごとの詳細ページ | 求人1件や物件1件のページ | 検索させ、sitemapに載せる。掲載が終わったら404か410を返す |
条件の一覧ページ | エリアと業種を掛け合わせた一覧 | 検索されていて掲載がある組み合わせだけを、sitemapに載せる |
並び替えや絞り込みのURL | 新着順、価格順、表示件数の切り替え | robots.txtで巡回を止めるか、canonicalで元の一覧を指す |
結果が0件の組み合わせ | 掲載の無いエリアと業種 | 404を返す。共通のエラーページへ転送しない |
とりわけ見落とされがちなのが、結果が0件の組み合わせです。中身の無い一覧が、正常を示すステータスコード200のまま返ると、クローラーは役に立たないURLを巡回し続けます。その場で「見つかりません」と表示し、404を返す作りにします。
sitemapは種類ごとに分けて送る
sitemapは、検索結果に出したい正規のURLだけを載せる一覧です。1つのsitemapに載せられるのは50,000件、圧縮前で50MBまでで、超える分はsitemapを分けるか、sitemapインデックスファイルにまとめて送信します。
分けるときは、詳細ページ用と一覧ページ用のように、ページの種類ごとに分けます。「ページ」レポートで一覧できるURLの例は1,000件までなので、数万ページのサイトでは未登録のURLを1件ずつ見て判断できません。種類ごとのsitemapで「ページ」レポートを絞り込めば、種類ごとに登録済みと未登録の件数を比べられます。
登録の割合が低い種類があれば、その種類のテンプレートの中身を直すか、検索させる対象から外すかを決めます。sitemapの作り方そのものはサイトマップのSEO効果と大規模サイトの扱いにまとめています。
robots.txt・noindex・canonicalの使い分け
robots.txt、noindex、canonicalの3つは、Googleに伝える中身と効く段階が違うため、URLの種類に合わせて使い分けます。
| 伝えること | 向いているURL | 注意点 | |
|---|---|---|---|
| robots.txt | このURLは巡回しない | 数が多く、検索させない並び替えや絞り込みのURL | リンクされていると、中身なしでURLだけ登録されることがある |
| noindex | このページは検索結果に出さない | 利用者には必要で、検索から人を呼ばないページ | 巡回は続くため、巡回の時間を減らす目的には使えない |
| canonical | 代表のURLはこれ | 同じ掲載が並ぶ、条件違いやパラメータ違いのURL | 強いシグナルだが、Googleが別のURLを代表に選ぶことがある |
巡回の時間を減らすならrobots.txt、検索結果から外すならnoindex、重複をまとめるならcanonicalが基本の組み合わせです。
canonicalを使うときは、sitemapに載せるURLとcanonicalで指すURLをそろえます。両者が別のURLを指していると、Googleに伝わる代表のURLが食い違います。指定したURLが代表として扱われているかは、URL検査の「Google が選択した正規 URL」で確かめられます。
未登録のURLが、並び替えや絞り込みのURLに偏っていませんか
未登録の理由が同じ種類のURLに集まっているなら、ページを足す前に、URLの設計と巡回の止め方を見直す段階です。無料相談(オンライン30分程度)では、「ページ」レポートの未登録の理由の画面を1点見せていただき、どの種類のURLから扱いを決めるかを一緒に確かめます。
インデックス登録を促す実務の手順
線引きを決めたうえで、登録させたいページに対して打つ手を順番に並べます。順番そのものに意味があるので、上から実行してください。
別のブラウザやシークレットウィンドウで、公開URLをそのまま開きます。会員向けの認証が掛かっていないか、公開設定が下書きのままになっていないか。認証が掛かったページや下書きのページは、Googleのクローラーも開けないため、ほかの手順を踏んでも登録されません。
サイト内のURL一覧をまとめたファイルを用意し、サーチコンソールから送信します。主要なCMSであれば自動生成の仕組みが用意されています。生成されたファイルに該当のURLが実際に入っているかまで、目で確かめてください。
新しいページは、どこからもリンクされていなければ見つけてもらえません。同じテーマですでに検索から人が来ている記事から、文脈に沿ってリンクを引きます。サイトマップに載せるだけより、この一手を加えたほうが見つけてもらいやすくなります。
URL検査に該当のURLを入力し、インデックス登録をリクエストします。1日に送れる件数には上限があるため、公開したページを片端から送るのではなく、優先したいページに絞って使ってください。
リクエストを最後に置いているのは、リクエストが「ここに新しいページがあります」と伝える手段であって、登録するかどうかを決めるのはあくまでGoogle側だからです。中身が整っていないページを何度送っても結果は変わりません。内部リンクの張り方そのものは内部リンクの設計と貼り方で詳しく扱っています。
Indexing APIを使えば記事を即座に登録できる、という話が出回ることがあります。Googleが公開している資料では、このAPIの対象は求人情報とライブ配信の動画に限られると明記されています。通常の記事に使っても効果はなく、無理に組み込む必要はありません。
手順を尽くしても登録されない場合、残るのは中身の評価です。検索した人の疑問に対して、他のページより答えになっているかが問われます。
インデックスされないときに疑う順番
原因の候補は多く見えますが、確認の順番を決めておけば絞り込みは早く終わります。設定側から先に確かめ、すべて問題がなければ中身を疑います。この順が効率的です。
- ページにnoindexが残っている
- robots.txtでクロールをブロックしている
- canonicalが別のURLを指している
- リダイレクトやエラーで、そもそも中身が返っていない
- どこからもリンクされていない孤立したページになっている
上の5つは、いずれも数分で確認できて、当てはまったものを直せば解決します。手間の割に効果が大きいので先に済ませてください。逆に、5つとも問題がないのに登録されないなら、原因は技術面ではありません。
サーチコンソールの表示ごとに対処が変わる点はGoogleにインデックスされない原因と対処法に、登録のリクエスト方法を手順で追いたい場合はGoogleのインデックスの仕組みと登録方法にまとめています。
インデックスに関するよくある質問
よくある質問を、実務での答え方でまとめました。
数時間で登録されることもあれば、数週間かかることもあります。時間そのものに規則性を見出すのは難しく、公開して2週間ほど様子を見ても動かないなら、時間の問題ではなく別の原因を探したほうが早く片付きます。
登録と順位は別の判断だからです。登録されていれば検索結果に出る資格はありますが、同じ語で他により良いページがあれば後ろに置かれます。記事名でそのまま検索して出てくるなら、登録は済んでいて、勝負しているのは順位のほうでしょう。
必須ではありません。既に登録済みのページは定期的に再訪されるため、修正はいずれ反映されます。ただし内容を大きく書き換えたときや、公開日を前に出したいときは、リクエストしておくと反映が早まる場合があります。
内訳を見てから判断してください。一覧ページやパラメータ付きURLが整理された結果なら、むしろ健全な減り方です。読んでほしい記事が外れているなら原因を追う必要があります。まず減った分がどのURLかを確かめましょう。
検索からの訪問がなく、内容も更新する予定がないページは、統合か削除の対象になります。ただし削除の前に、そのページへの内部リンクと外部からのリンクを確認してください。リンクが集まっているページは、内容を書き直して残したほうが有利な場合があります。
まとめ|インデックスは増やすより選ぶ
インデックスは、検索結果に出るための前提であって、順位そのものではありません。登録されて初めて土俵に上がり、そこから中身で比べられます。まずはこの2段階を分けて考えるところから始まります。
そして件数そのものを追う運用からは、そろそろ抜けてよいはずです。記事数と登録件数の差は、内訳さえ分ければ放っておける差と直すべき差にきれいに分かれます。検索から人が来る前提のないページまで預ける必要はありません。預けるページを絞ったほうが、読んでほしい記事は見つけてもらいやすくなります。
確認はサーチコンソールで行い、登録はサイトマップと内部リンクとリクエストの順に促します。それでも登録されないなら、中身を作り直す段階に入った合図だと受け取ってください。
数千〜数万ページのデータベース型サイトでは、登録を促す前に、URLの種類ごとに検索させるかを決めます。検索させないURLはrobots.txtで巡回を止め、重複はcanonicalで代表を指定し、sitemapには検索させるURLだけを載せます。
私たち合同会社Writers-hubは、累計8,000記事以上の記事を制作してきたほか、数千〜数万ページ規模のサイト向けにデータベースSEOを提供しています。
検索させるURLと巡回を止めるURLを、自社サイトでは分けられていますか
データベースSEOでは、内部リンクとURLの設計、ページの種類ごとのtitle・meta description・構造化データの調整、クロールバジェットの配分とsitemap・canonicalによるインデックスの制御を行います。未登録が特定の種類のURLに集まっている段階なら、どの種類から扱いを決めるかの相談から始められます。


